模型与系统设置
模型、文档解析、结构增强、视觉检索是全平台共用的,由系统管理员在「管理后台」→「系统」→「模型」里配,所有空间的成员都能用。密钥加密保存在数据库里,只在服务端使用,保存后界面上不再显示明文。
接入厂商
「厂商」页点添加,填:
| 字段 | 说明 |
|---|---|
| 名称 | 自己起,比如「DeepSeek」「公司 vLLM」 |
| API 地址 | OpenAI 兼容接口的地址,一般以 /v1 结尾 |
| API Key | 服务商给的密钥;自建服务没有密钥可以不填 |
云服务(DeepSeek、阿里百炼、硅基流动、智谱、火山方舟等)和自建的 vLLM、SGLang、Ollama 都可以,只要是 OpenAI 兼容接口。
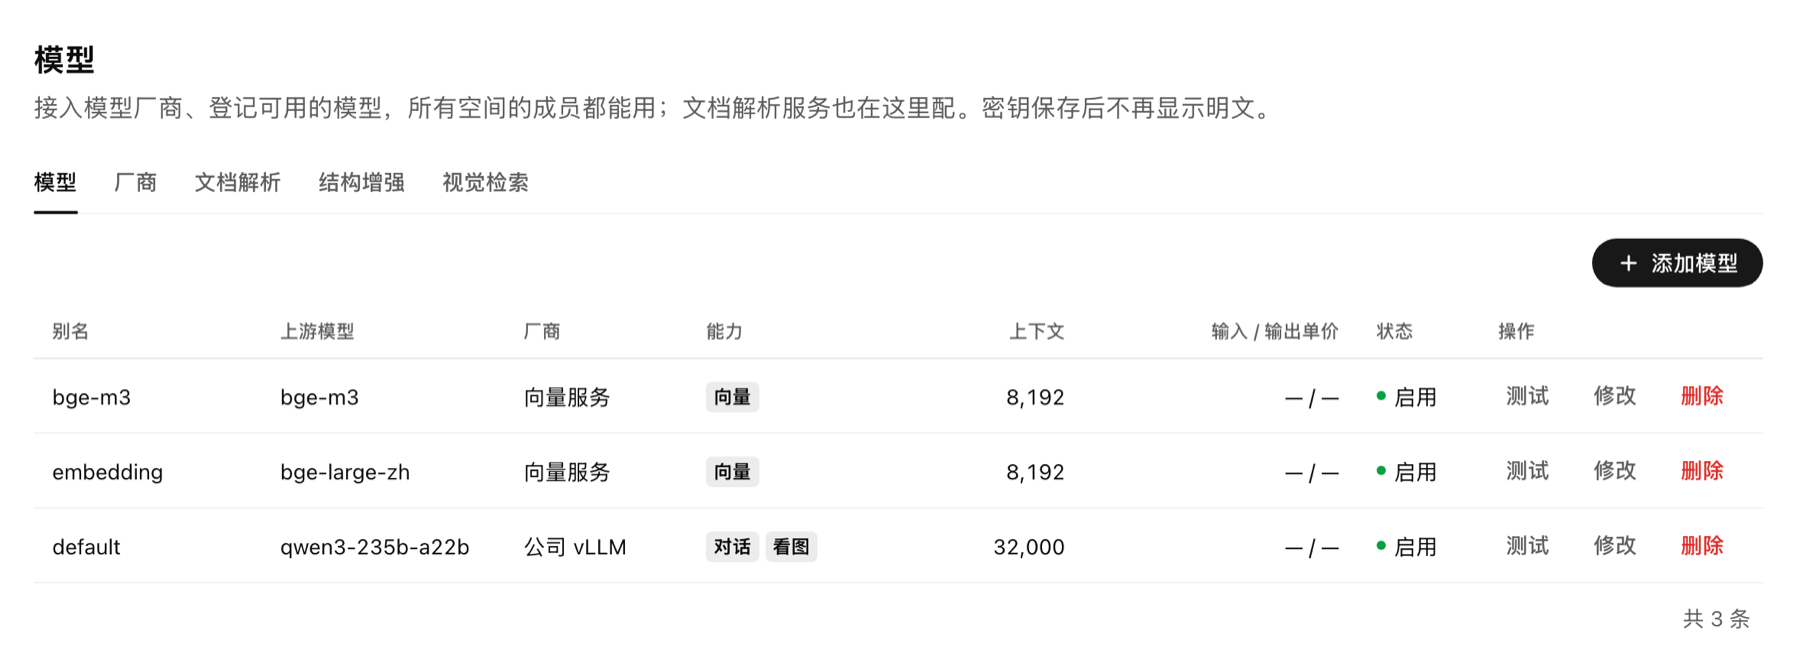
登记模型
「模型」页点「添加模型」:
| 字段 | 说明 |
|---|---|
| 厂商 | 选上一步加的 |
| 别名 | 在 KnowWork 里引用这个模型的名字。对话模型里要有一个别名叫 default,智能助手默认用它 |
| 上游模型名 | 服务商那边的模型名,比如 deepseek-chat、qwen-plus |
| 能力 | 对话、向量、重排序、看图,可多选 |
| 思考 | 只对对话模型:跟随服务默认、开启或关闭 |
| 上下文长度 | 模型支持的最大 token 数 |
| 输入 / 输出单价 | 元 / 百万 token,填了以后用量页和问答大盘能估算费用 |
登记完点「测试」,确认调得通。
各能力的模型用在哪:
- 对话:智能助手作答、快速问答、自动抽取元数据、生成知识库描述、多跳检索抽取等;
- 向量:知识库的语义检索,建知识库时选;
- 重排序:可选,在知识库设置里选,让排序更准;
- 看图:可选,给文档里的图补中文描述,智能助手看图片附件时也用它。
关掉思考能快不少
Qwen3 这类模型在自建服务上默认开着思考,每一步先想一段再动手,回答要多等几秒。日常问答把「思考」设成关闭会快很多;复杂任务多的场景可以单独登记一个开着思考的别名。
模型目前对空间内所有成员开放,不能按人或部门限制。要控制成本,靠「用量」页定期看按人、按模型的消耗,见运营与审计。
文档解析
「文档解析」页配置 MinerU,用来解析 PDF、Word、PPT(知识库文档和对话附件都用它):
| 字段 | 说明 |
|---|---|
| 启用文档解析 | 打开才会解析 |
| MinerU 地址 | MinerU 3.x 的 API 地址,KnowWork 服务器要能访问到 |
| 解析模式 | 自动、VLM、hybrid、pipeline。默认「自动」就好;版面复杂、效果不好时可以改用 VLM |
| VLM 服务地址 | MinerU 的 VLM 推理服务(常见 30000 端口),VLM、hybrid 模式必填 |
| 访问令牌 | 用 MinerU 官方 API 时填 |
| 识别语言 | 扫描件、图片里文字的语言 |
| 同时解析上限 | 按 MinerU 的并发上限设,附件与知识库一起算 |
保存后几秒内生效,不用重启。解析失败时,文档的「后台任务」里会写明原因,比如 MinerU 连不上、文件损坏。
结构增强、视觉检索两页的配置见可选服务。
系统设置
「管理后台」→「系统设置」:
- 品牌:产品名称和 Logo,显示在浏览器标签、侧栏和登录页,可以换成你们自己的名字;
- 系统信息:KnowWork 版本、数据库版本、授权状态与到期时间、已加载的扩展模块。授权显示无效时,见常见问题。
「运行面板」里能看到后台任务(文档解析、嵌入、自动抽取等)的排队、执行情况和 worker 心跳,排查「文档一直在排队」这类问题时用。